
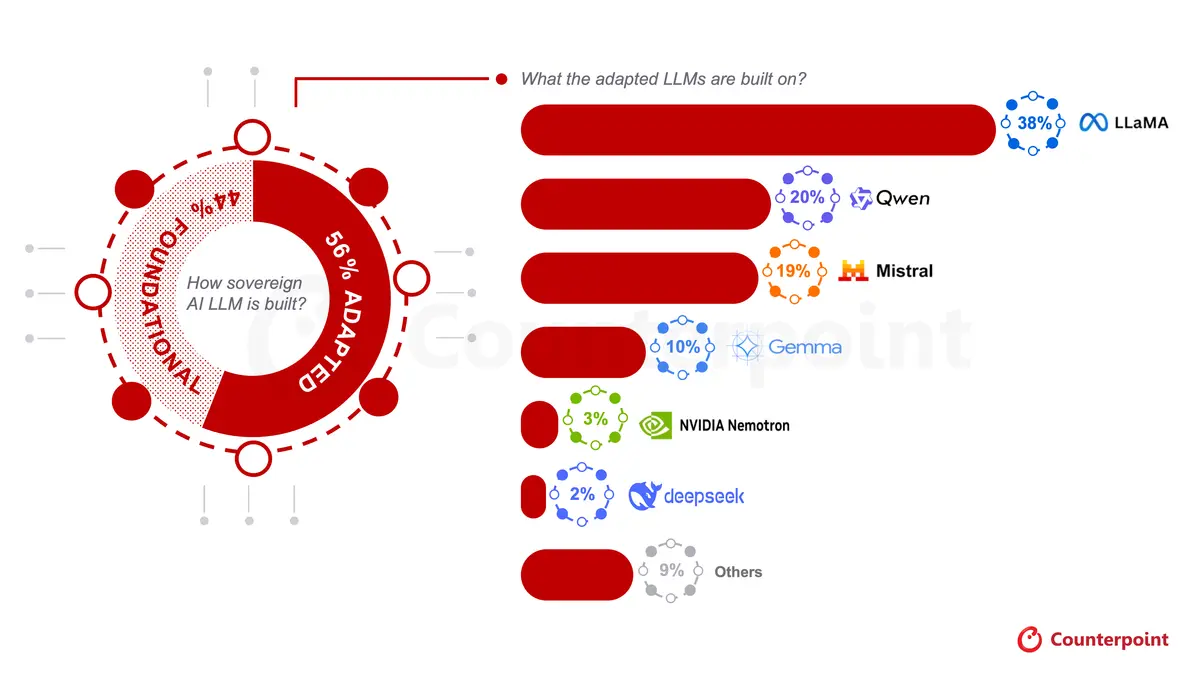
- Die Mehrheit der erfassten souveränen LLMs sind angepasste Modelle, die auf bereits existierenden Open-Source-Grundlagen basieren, mit einem Anteil von 56 %. Grundlagenmodelle, die mit nativen Daten trainiert wurden, folgen dicht dahinter mit 44 %.
- Llama ist die dominierende ausländische Basismodellfamilie und macht 38 % der angepassten souveränen LLMs aus.
- Qwen und Mistral folgen als enge Herausforderer mit nahezu gleichen Anteilen von 20 % bzw. 19 %.
- Angepasste souveräne KI-LLMs bleiben daher weitgehend von ausländischen Anbietern abhängig, namentlich den LLM-Grundlagenfamilien aus den USA und China.
Peking, Buenos Aires, Dubai, Hongkong, London, Neu-Delhi, Seoul, San Francisco, Taipeh, Tokio – 21. Sep. 2026
Angepasste Modelle machen mit einem Anteil von 56 % den Großteil des Mixes bei souveränen LLM-Entwicklungen aus, angetrieben durch Metas Llama, das laut dem H1 2026 Sovereign AI LLM Index von Counterpoint Research die bevorzugte US-Open-Source-Grundlage für souverän angepasste LLMs ist und einen beachtlichen Anteil von 38 % einnimmt. Bemerkenswert ist, dass die Llama-LLM-Familie in allen in unserer Untersuchung bewerteten Regionen die dominierende Basis darstellt.
Die meisten Länder kombinieren in ihren Portfolios grundlegende und angepasste LLMs, was die unterschiedlichen Reifegrade souveräner KI-LLMs widerspiegelt. Der Schritt zur Entwicklung grundlegender LLMs auf Basis nativer Daten ist ein strategisch entscheidender Schritt, wenn man deren relativ schwierige und kostspielige Implementierung berücksichtigt.
Marc Einstein, Research Director bei Counterpoint Research, kommentierte die Ergebnisse wie folgt: „Bei souveräner KI geht es um Kontrolle und strategische Autonomie, aber Kontrolle ist eher ein Kontinuum als ein Schalter. Eine knappe Mehrheit der ‚souveränen‘ LLMs basiert auf ausländischen Open-Source-Grundlagen, daher ist echte Autonomie immer noch die Ausnahme. Was zählt, ist die Richtung der Entwicklung, und unsere Studie zeigt einen klaren Trend hin zu grundlegenden Modellen, die von Grund auf mit nativen Daten erstellt werden.“
In den ersten beiden Teilen dieser Analyse haben wir unsere Studie vorgestellt und mehr als 170 Modelle in über 55 aktiven souveränen LLM-Nationen im Nahen Osten, Mittel- und Osteuropa, Westeuropa, im asiatisch-pazifischen Raum (APAC, ohne China), Zentralasien, Afrika, Nordamerika (Kanada, ohne USA) und CALA bewertet, um zu verstehen, wie Nationen außerhalb der USA und Chinas darum konkurrieren, inländische LLM-Kapazitäten und KI-Infrastruktur aufzubauen.
Lesen Sie die früheren Teile dieser Serie auf der Website von Counterpoint Research: Teil 1 zum H1 2026 Sovereign AI LLM Index Ranking und Teil 2 zur KI-Chip-Infrastruktur hinter souveränen LLMs.
Die vollständige Studie, Sovereign AI LLM Research Report: Mapping the Global Race to Build Domestic LLMs, ist ebenfalls dort verfügbar.
Diese Analyse deckte verschiedene Dimensionen ab, darunter die Art der souveränen LLM-Modelle, die KI-Chip-Infrastruktur für Training und Inferenz sowie LLM-Fähigkeiten in Bezug auf souveränes LLM-Eigentum, grundlegende Entwicklung, Tiefe der lokalen Sprache und Anwendung. Hier, aufbauend auf derselben Studie, führen wir die Analyse weiter und untersuchen die angepassten Modelle nach Basismodellfamilie.
Counterpoints Anteil souveräner KI-LLMs an angepassten Modellen nach Basismodellfamilie
Quelle: Counterpoint Research: AI 360 Practice: Sovereign AI Research, Juli 2026
Dicht hinter Llama wird Chinas Qwen zunehmend als zentrale Grundlage für lokal angepasste Modelle in Mittel- und Osteuropa, im asiatisch-pazifischen Raum und in Afrika eingesetzt, wobei die breitere mehrsprachige Basis und die effiziente Architektur offener Modelle genutzt werden, um lokale Sprachanpassungen zu ermöglichen.
Das französische Modell Mistral, ein in Westeuropa entwickeltes Basismodell, erweist sich als starker Herausforderer und festigt seine Position im Nahen Osten durch strategische Partnerschaften wie mit G42, neben einer breiteren Akzeptanz in Westeuropa, Mittel- und Osteuropa sowie im asiatisch-pazifischen Raum.
Weitere Informationen darüber, wie Abu Dhabi diese Partnerschaften in einsatzbereite KI umwandelt, finden Sie unter Counterpoint Conversations: Abu Dhabi’s Digital Blueprint to Deploy Predictive, Proactive and Responsible AI at Scale, aufgezeichnet im Rahmen der GITEX Global im letzten Jahr.
Betrachtet man die verschiedenen Regionen, so greifen angepasste LLMs zunehmend auf eine breitere Palette von Grundlagen wie Llama, Qwen, Mistral, Gemma, NVIDIA Nemotron und DeepSeek zurück. Dies spiegelt eine Diversifizierung wider, um die vollständige Abhängigkeit von einer einzigen Grundlage zu verringern.
Über Counterpoint Research
Counterpoint Research ist ein globales Marktforschungsunternehmen, das auf Produkte im gesamten Technologie-Ökosystem spezialisiert ist. Wir beraten eine Vielzahl von Kunden – von Smartphone-OEMs bis hin zu Chipherstellern, Channel-Akteuren und Big-Tech-Unternehmen – über unsere Büros in den wichtigsten Innovationszentren, Fertigungsclustern und Handelszentren der Welt. Unser Analystenteam, das von erfahrenen Experten geleitet wird, arbeitet mit Stakeholdern im gesamten Unternehmen zusammen – von der Geschäftsführung bis hin zu Fachleuten in den Bereichen Strategie, Analyst Relations (AR), Market Intelligence (MI), Business Intelligence (BI), Produkt und Marketing – um Dienstleistungen anzubieten, die Marktdaten, Branchen-Thought-Leadership und Beratung umfassen. Unsere Kernbereiche umfassen KI, Automotive, Unterhaltungselektronik, Displays, eSIM, IoT, Standortplattformen, Makroökonomie, Fertigung, Netzwerke und Infrastruktur, Halbleiter, Smartphones und Wearables. Besuchen Sie unsere Insights-Seite, um unsere öffentlich zugänglichen Marktdaten, Erkenntnisse und Thought-Leadership-Inhalte zu erkunden, unseren Fokus zu verstehen, unsere Analysten kennenzulernen und ein Gespräch zu beginnen.
Folgen Sie Counterpoint Research
